IP 承载网是千行万业数字化系统的底座。一次刷卡支付、一次线上挂号,背后都离不开它。然而,这张网一旦出故障,线索往往深埋在海量的告警或静默的配置中。业务中断时,排障的第一道门槛往往不是怎么修,而是理清——“此时此刻,这张网到底长什么样?”
想要回答这个问题,门槛极高。因为真实的现网是“活”的、动态的。每一次故障的网络拓扑空间都截然不同,面对错综复杂的路由,能在脑海中实时重构出“动态网”并揪出根因的,只有极少数资深专家。
既然资深专家可遇不可求,将排障重任交给大模型 Agent(智能体),便成了行业破局的共识。业内曾普遍以为,凭借大模型强大的知识理解、逻辑推理与分析决策能力,这会是一场降维打击。
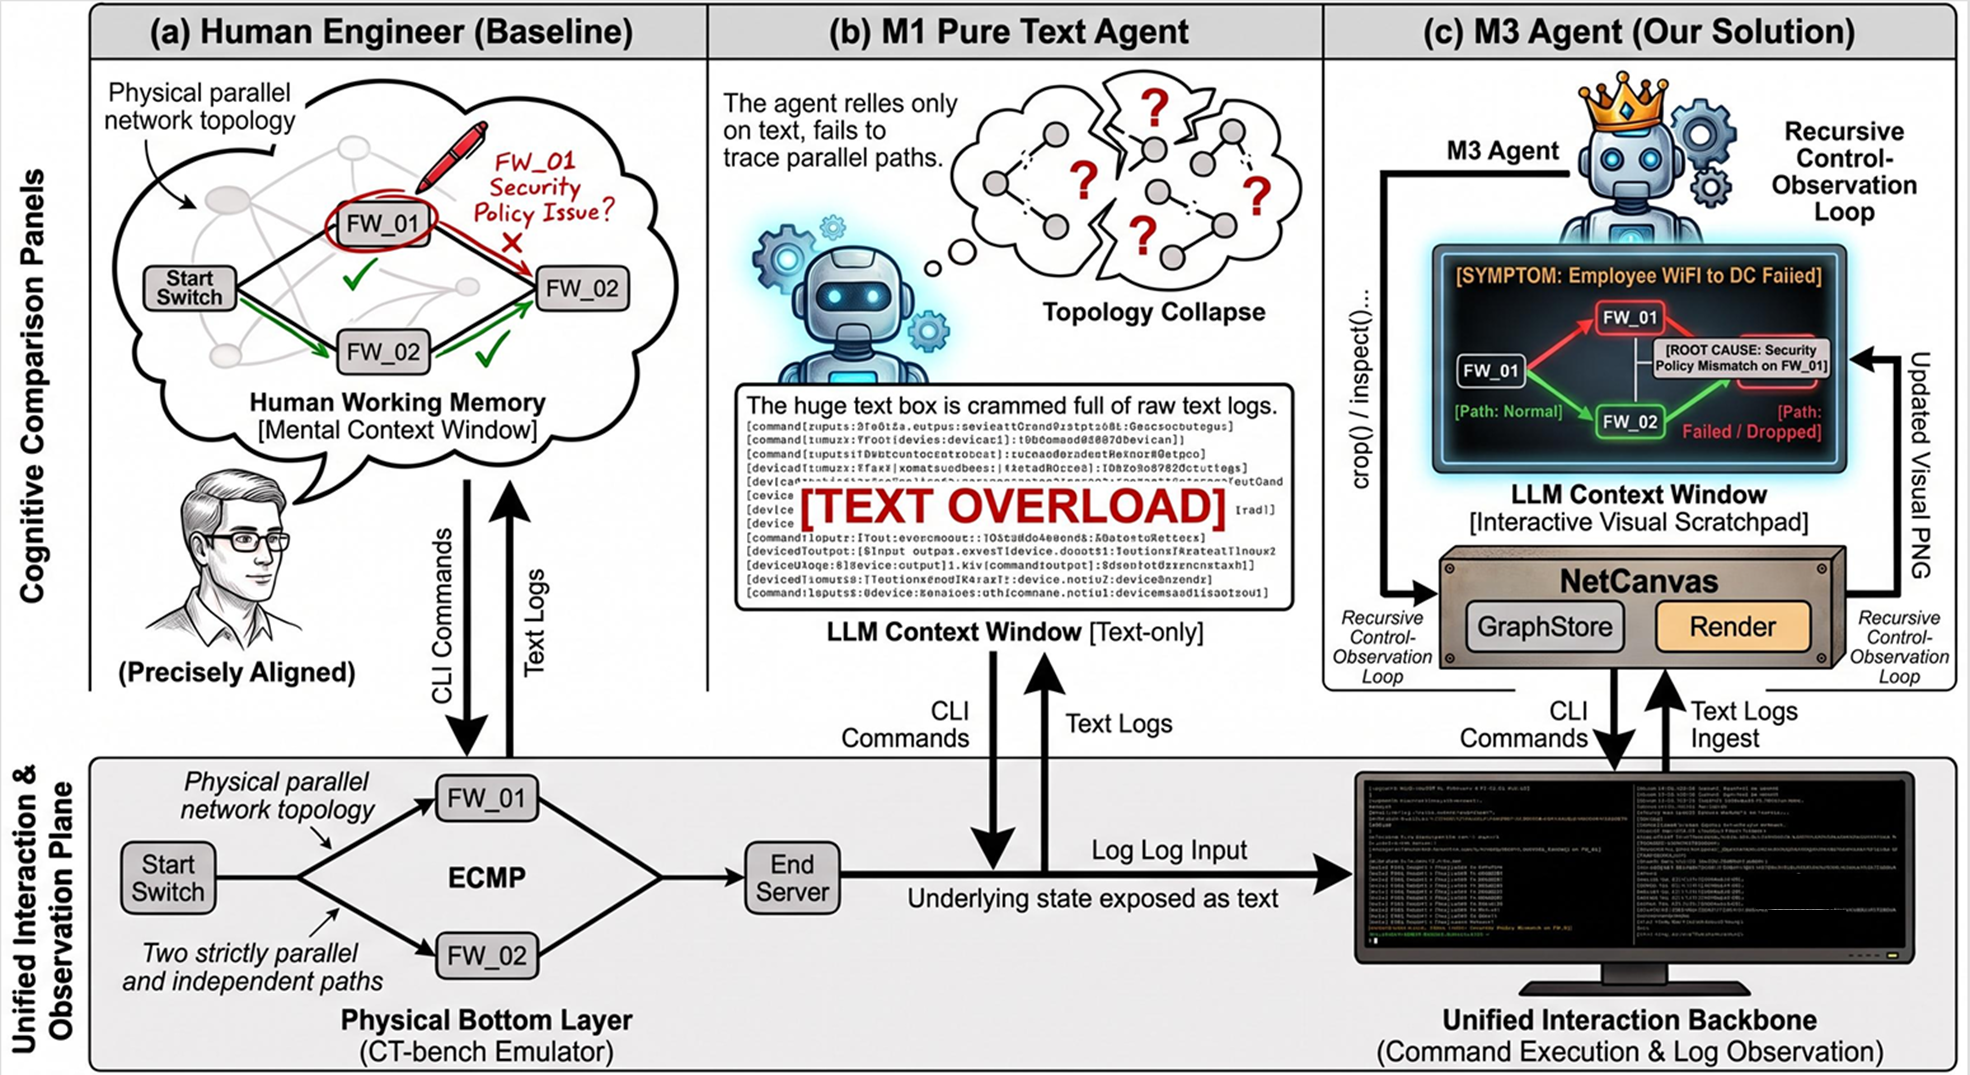
然而,当承载着厚望的 Agent 真正走进现场后,华为 GTS 算法团队却发现了一个反直觉的致命痛点:AI 的推理能力再强,读得懂海量的文本日志,却偏偏记不住这张网长什么样。团队将此称为「拓扑失忆」。让一个纯文本 Agent 在脑海里硬扛成百上千个节点的动态变化,注定会陷入记忆坍塌。
如何破局?团队给出了精准解法——NetCanvas:引入一套「可交互视觉拓扑」机制,为大模型提供了一张可以画线推演的「外部工作记忆」画布。让 AI 真正学会“认知卸载”,像专业工程师一样“看着网络排障”。
01 / 痛点剖析:AI 读得懂日志却修不好网?缺的是一张跟着排查更新的拓扑图
引入大模型 Agent,原本是为了复刻资深专家的排障经验、填补现网的人力缺口。但一线很快碰到一个反直觉现象——模型明明能解析单条命令、单段回显,一旦进入多设备、多路径、带防火墙与 ECMP 的真实复杂拓扑,就开始绕弯、重复探查,甚至在同一节点打转。
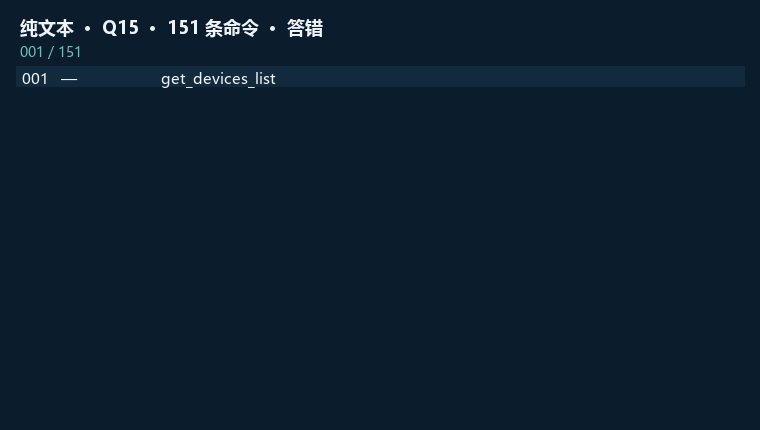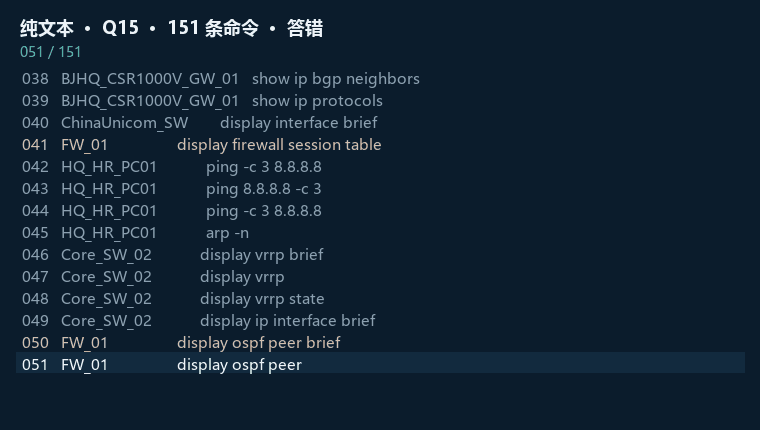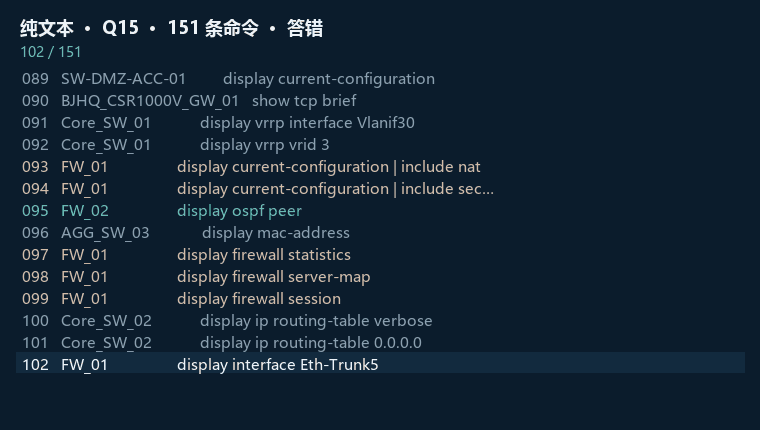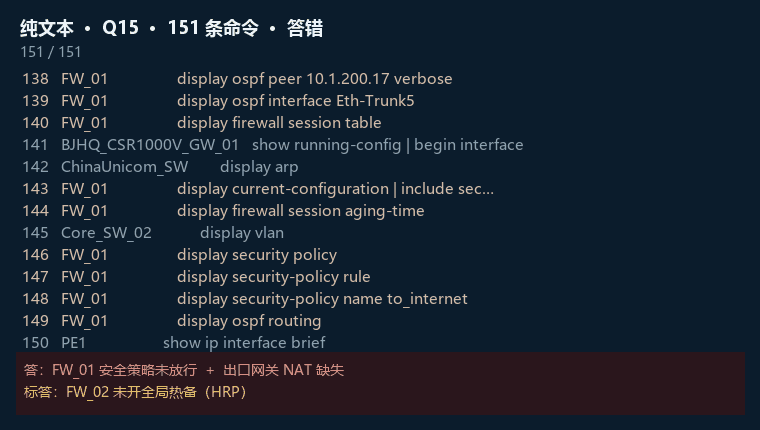
一个典型的案例是:一台办公 PC 上不了外网,网里有一对互为热备的双防火墙,标准答案是其中一台没启用全局热备协议(HRP)。纯文本 Agent 发了 151 条命令,把两台防火墙的热备状态都查过了——证据它拿到手了。但它最后把根因判给了另一台防火墙的安全策略,还捎带上一台出口网关的 NAT 配置:两条都错,而且认错了是哪一台在这条路径上出问题。它会查热备、读得懂回显,却不知道这两台并行的防火墙,各自站在整个图里哪条路径的第几跳。
明明推理能力在线,为什么 AI 还会迷路?答案是:缺了空间记忆。
资深网工排障时,脑子里始终悬着一张不断更新的拓扑图:流量从哪里进入、在哪分流、防火墙卡在第几跳,一切清清楚楚。反观纯文本 Agent,面对的却是一维滚动的 CLI(命令行)——每推进一步,都要从碎片的日志里重新脑补网络长什么样。上下文越长,这种空间关系就越容易在长文本里「坍塌」。
针对这一现象,华为 GTS AI 算法团队将其精准命名为「拓扑失忆」(Topology Amnesia):排障越深入,局部观测可能越来越多,整体的空间关系却在逐渐丢失。
怎么破局?既然人脑都需要依靠图纸来梳理复杂逻辑,AI 自然也一样。拓扑图对网工来说是排障时的“外部工作记忆”,查到哪,图更新到哪。因此,Agent 需要一张能与它产生交互、随排查一起更新的拓扑图。
沿着这个逻辑,GTS 的解法是把专家的工作方式写进 Agent 系统:模型负责思考决策,NetCanvas 负责记路与画图。
02 / 技术方案:一张「探查—入图—渲染—决策」的可交互视觉拓扑
NetCanvas 是一套运行时机制:后台随探查维护一份持续更新的网络图状态,前台把当前任务相关的局部结构渲染成可交互的拓扑视图,交给模型。
整条链路是一个闭环,分四步。
第一步,探查。 Agent 对指定设备下发 CLI,例如读路由表、接口状态或配置片段,环境返回原始文本回显。
第二步,入图。 由一个专门的抽取模型把非结构化回显解析成路由条目、接口、OSPF 邻居、下一跳这些对象,合并进持续累积的拓扑图。
第三步,渲染。 按网络工程习惯的区域布局,从当前图状态切出目标子图,画成一张图。每渲染一次,同时生成一份索引,记下每个实体的标识、它画在哪个位置、哪块区域可以点。Agent 拿到的是当前这一步的视图加上这份索引。
第四步,决策。 Agent 基于当前视图选择下一步:继续发命令,或先在图上操作。图上的操作走语义指令:点某台设备、点某条链路、追某条路径;后台照那份索引定位、裁剪、重绘,返回新的一帧视图。下一步的图是系统按它的请求现画出来的。抽取失败或命令不在白名单时,这一步退回成纯文本原始回显,不影响可用性。
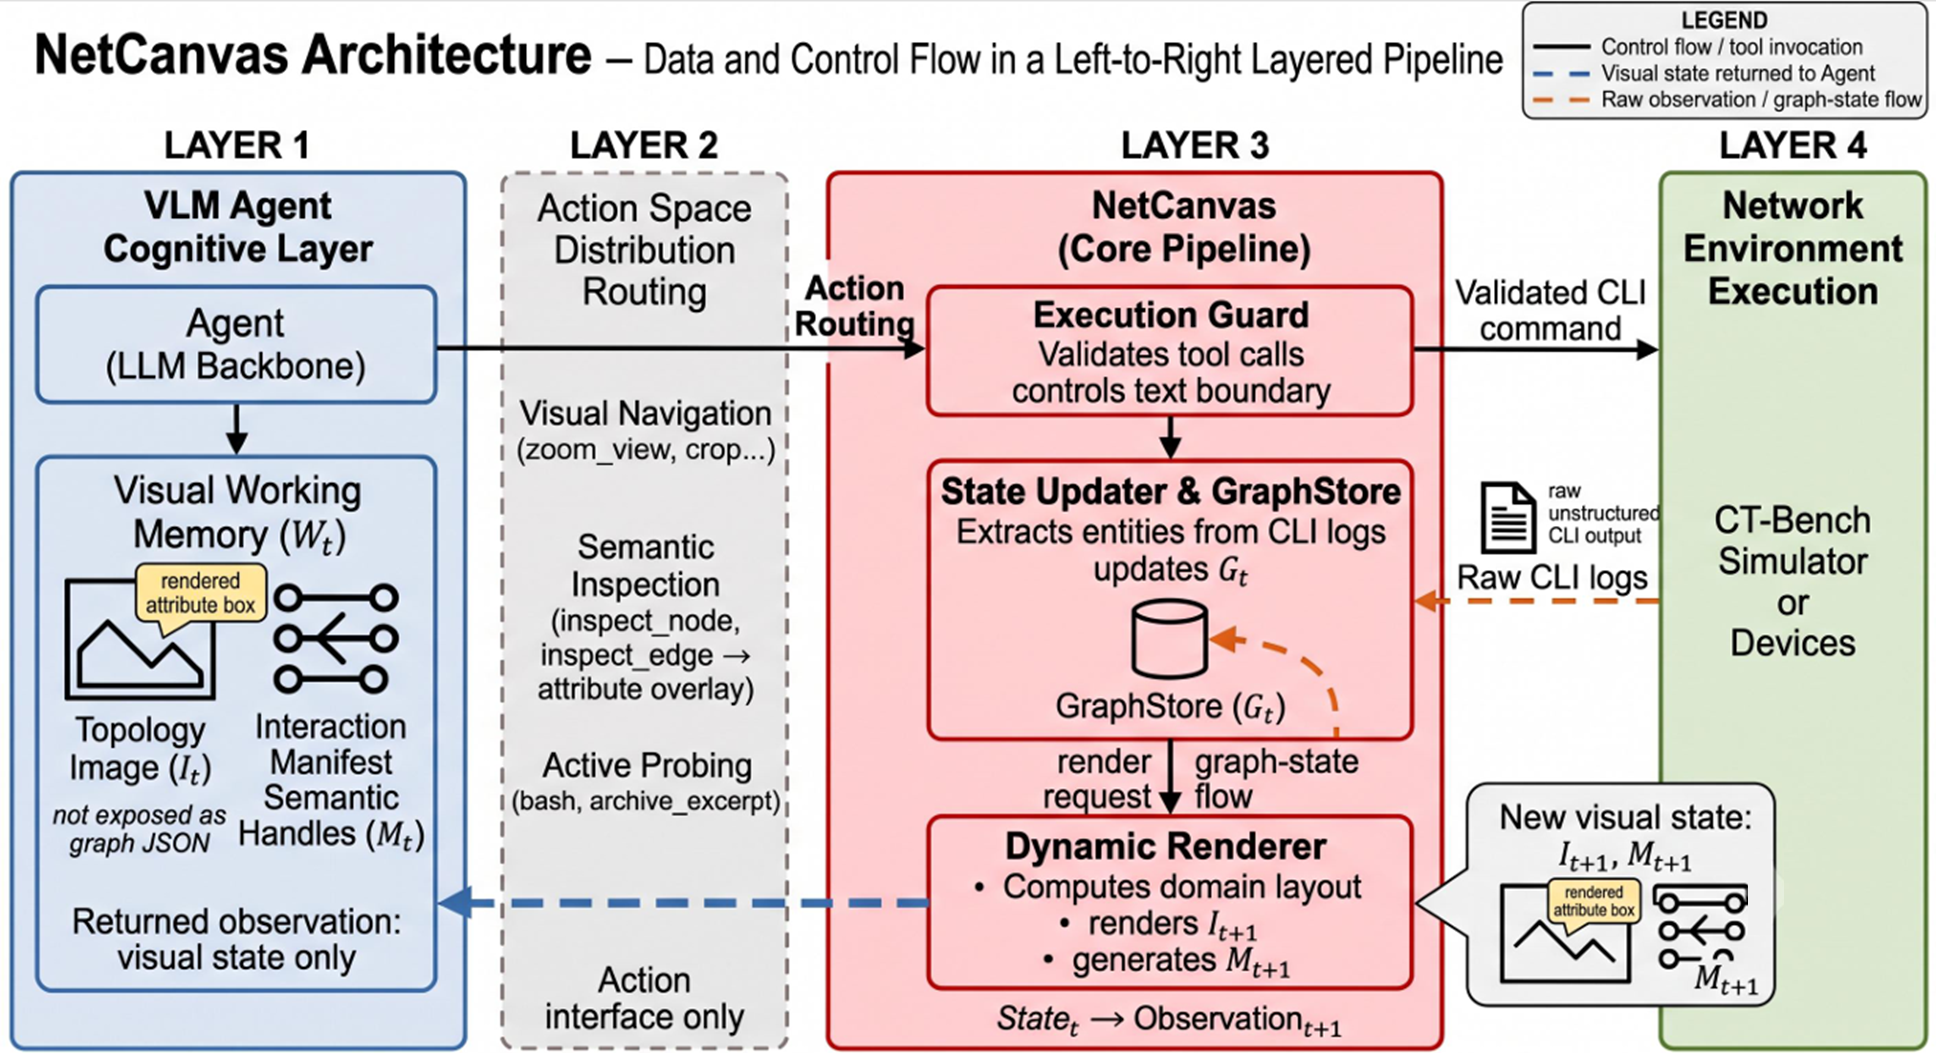
这个闭环最终以八个工具的形式开放给 Agent(工具名为实验代码里的实际接口名):
| 工具 | 它想干什么 | 系统给它什么 |
|---|---|---|
flush_and_render | 发一条命令,并把这轮新证据立刻画出来 | 入图后的拓扑图 + 索引 |
render_topology | 换取景:全局总览 / 设备邻域 / 端到端路径,或切换物理 / 逻辑 / 控制 / Overlay / 安全平面 | 从已累积的图状态重画 |
crop_node | 就近看某个节点的三跳邻域和属性 | 局部图 + 属性框叠在图上 |
trace_route_path | 追三层转发路径 | 按路由与下一跳证据高亮,并标明这条链是否闭合 |
trace_l2_paths | 追二层 / 物理连通 | 按端口、LLDP、对端链路证据高亮 |
inspect_visual_node | 问某个节点的底层证据 | 命中节点高亮 + 属性框回贴到图上 |
inspect_visual_edge | 问某条链路的底层证据 | 命中链路高亮 + 属性框回贴到图上 |
draw_agent_path | 把自己的判断写回图上 | 按它给的跳序和每跳通断,画成绿 / 红虚线 |
前七个工具主要让 Agent 探查、取景和检视,第八个则让它把判断写回图上:Agent 给出一串设备顺序,再对每一跳标注自己认为通还是断,系统把这串假设画成绿红虚线叠在拓扑上——之后同一平面的重绘会自动带上这些线。系统不替它验证转发是否真的成立,画上去的就是它自己的推断。这个补充接口不参与前述双防火墙轨迹的定位过程。
四步闭环说的是流程怎么跑;流程之内,还有三个容易被忽略的设计决定,后面的对照实验会分别验证它们。
一是图跟着探查长。 真实的排障现场,没有人能在第一时间拿到完美的全局拓扑。入图那一步每跑一次,新发现的设备、链路与路径证据就合并进当前图状态——Agent 认的是一张跟着探查一起生长的拓扑。
前面 01 节那道双防火墙的题,换成 NetCanvas 之后可以逐帧看清拓扑是怎么长出来的:探到核心,两侧防火墙先露头;焦点移到防火墙,路径开始成形;出口网关齐了,整条路径才落在图上。两台防火墙的并行关系一旦在图上摆开,问题就从「哪台防火墙有毛病」变成了「这条路径上这台防火墙该起什么作用」。这一次它用了 49 次工具调用,其中只有 5 次是发命令,答案一次就对——对面纯文本那条轨迹是 151 次调用、全部在发命令。
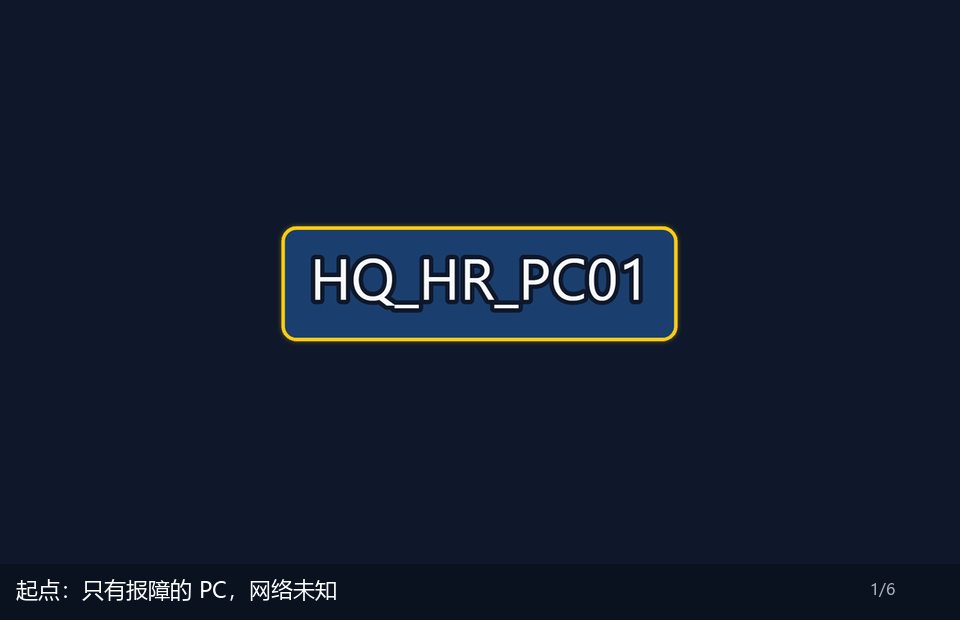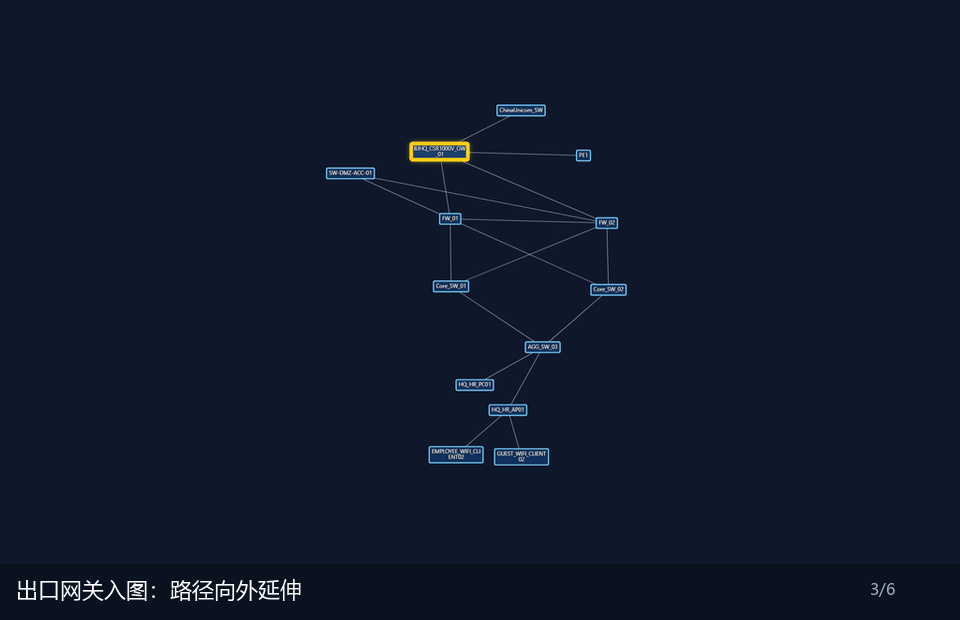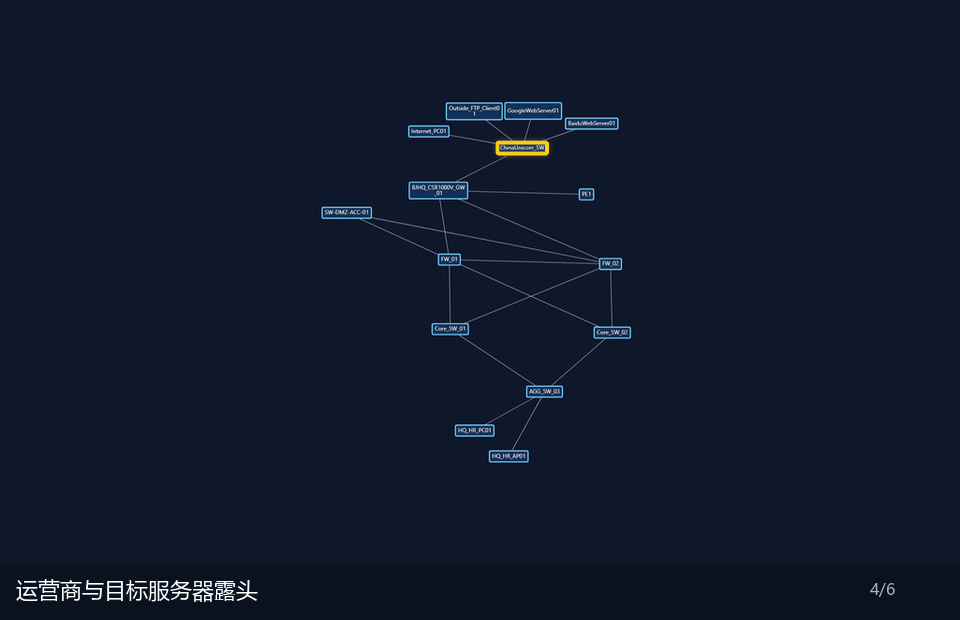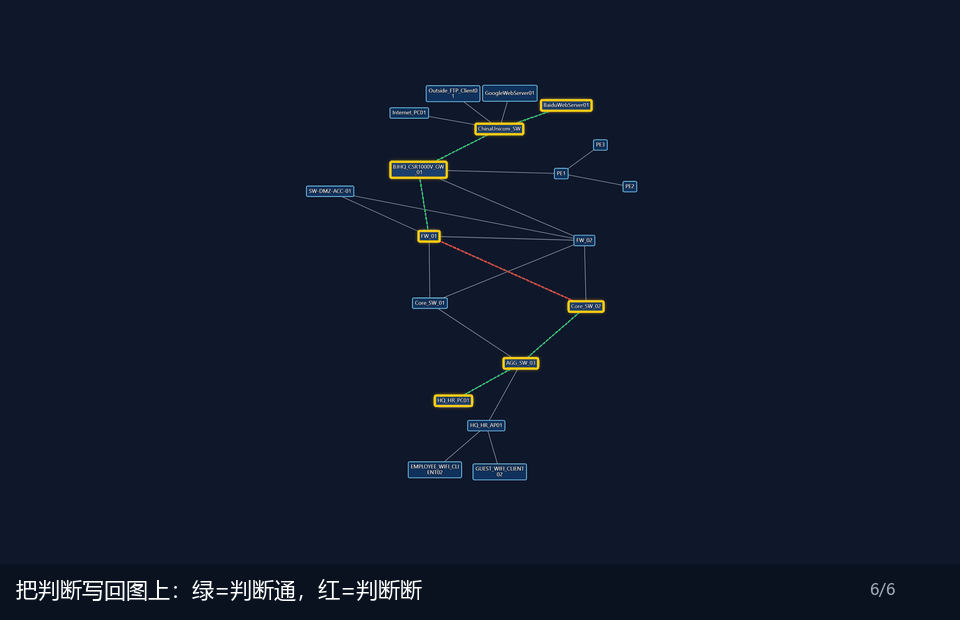
二是每步只给当前视图。 完整的图状态不适合直接塞进有限的上下文。渲染那一步切出来的始终是围绕当前任务的局部:切换全局与局部视图、围绕焦点设备裁剪、高亮当前路径、查看节点与链路属性,还可以在图上标记通断假设。空间状态交给系统维护,模型不必在脑子里死记硬背整张网。
三是按网工习惯的领域布局画。 设备按园区 / 广域、核心 / 接入、安全域归组,路径走向有章法,接近工程师手绘的草图。布局编码的是园区、核心、安全域这些工程语义——看见什么重要,以什么方式呈现同样重要。这一点,后面的对照实验会单独验证。
03 / 数据验证:66 道真实故障题,只换工作记忆的组织方式
验证放在公开基准 CTBench 的前 66 道故障定位题(Q1–Q66)上。题目源自真实运维案例:Agent 要进入未知网络、自己发命令,从不完整证据里给出规范化根因(故障节点、故障对象、根因)。难度远超单轮问答——证据是局部的,拓扑是未知的,根因往往在跨设备的那一跳上。
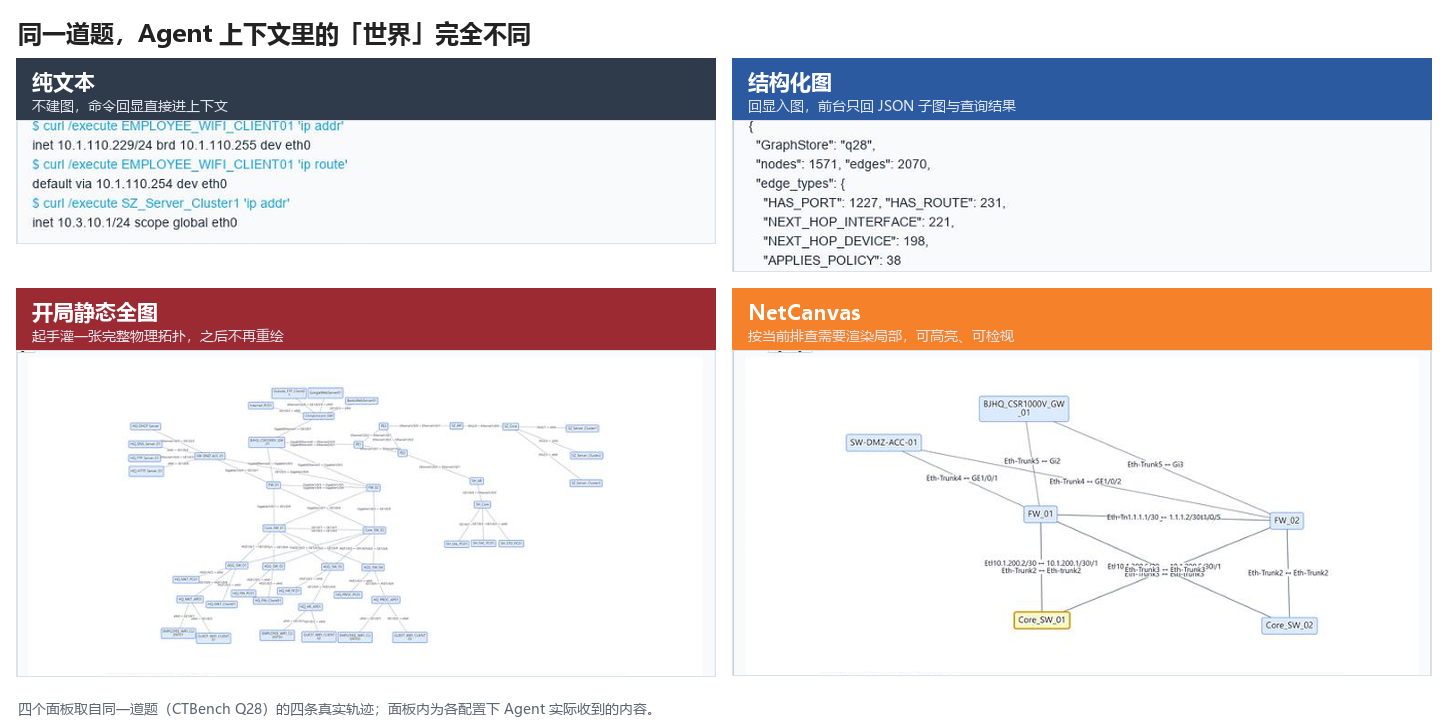
对照实验把工作记忆形态当成唯一自变量。底座模型、Agent 的 harness 框架、评分规则、底层 CLI 数据源全部固定,变的只是上下文里那份「世界」怎么组织:
- 纯文本:回显直接进上下文,拓扑必须在脑子里拼。
- 结构化图:同样入图,前台只给 JSON 子图和查询结果,没有图像。
- NetCanvas:走完探查 → 入图 → 渲染 → 决策,按需取景、高亮路径、检视属性。
在这三类之上,还各加了两种事先给拓扑的对照,区别在于给的是图还是数据。两者都只给物理平面:设备和物理连线,不含逻辑平面、路由表、ACL、接口状态、端口配置、协议状态,也不含故障答案;逻辑状态仍须靠 CLI 探查获得。
- 开局静态图:一张画好的物理拓扑图。开局给一次,之后不再更新、不能交互。
- 预置连线数据:同一份物理平面拓扑数据,预置进各自的工作记忆。纯文本侧是一段连线文字说明,结构化图侧进后台图库,NetCanvas 侧成为底图、后续探查继续画在上面。
再加上一个只换渲染布局的消融,一共九条对照臂。底座统一 MiniMax-M3;每题最多 1 小时;每个(题目, 配置)最多独立重复 3 次,任一次命中即算通过。判分是严格集合匹配。一步就是一次工具调用,发一条 CLI 和在图上换一次取景都算一步。
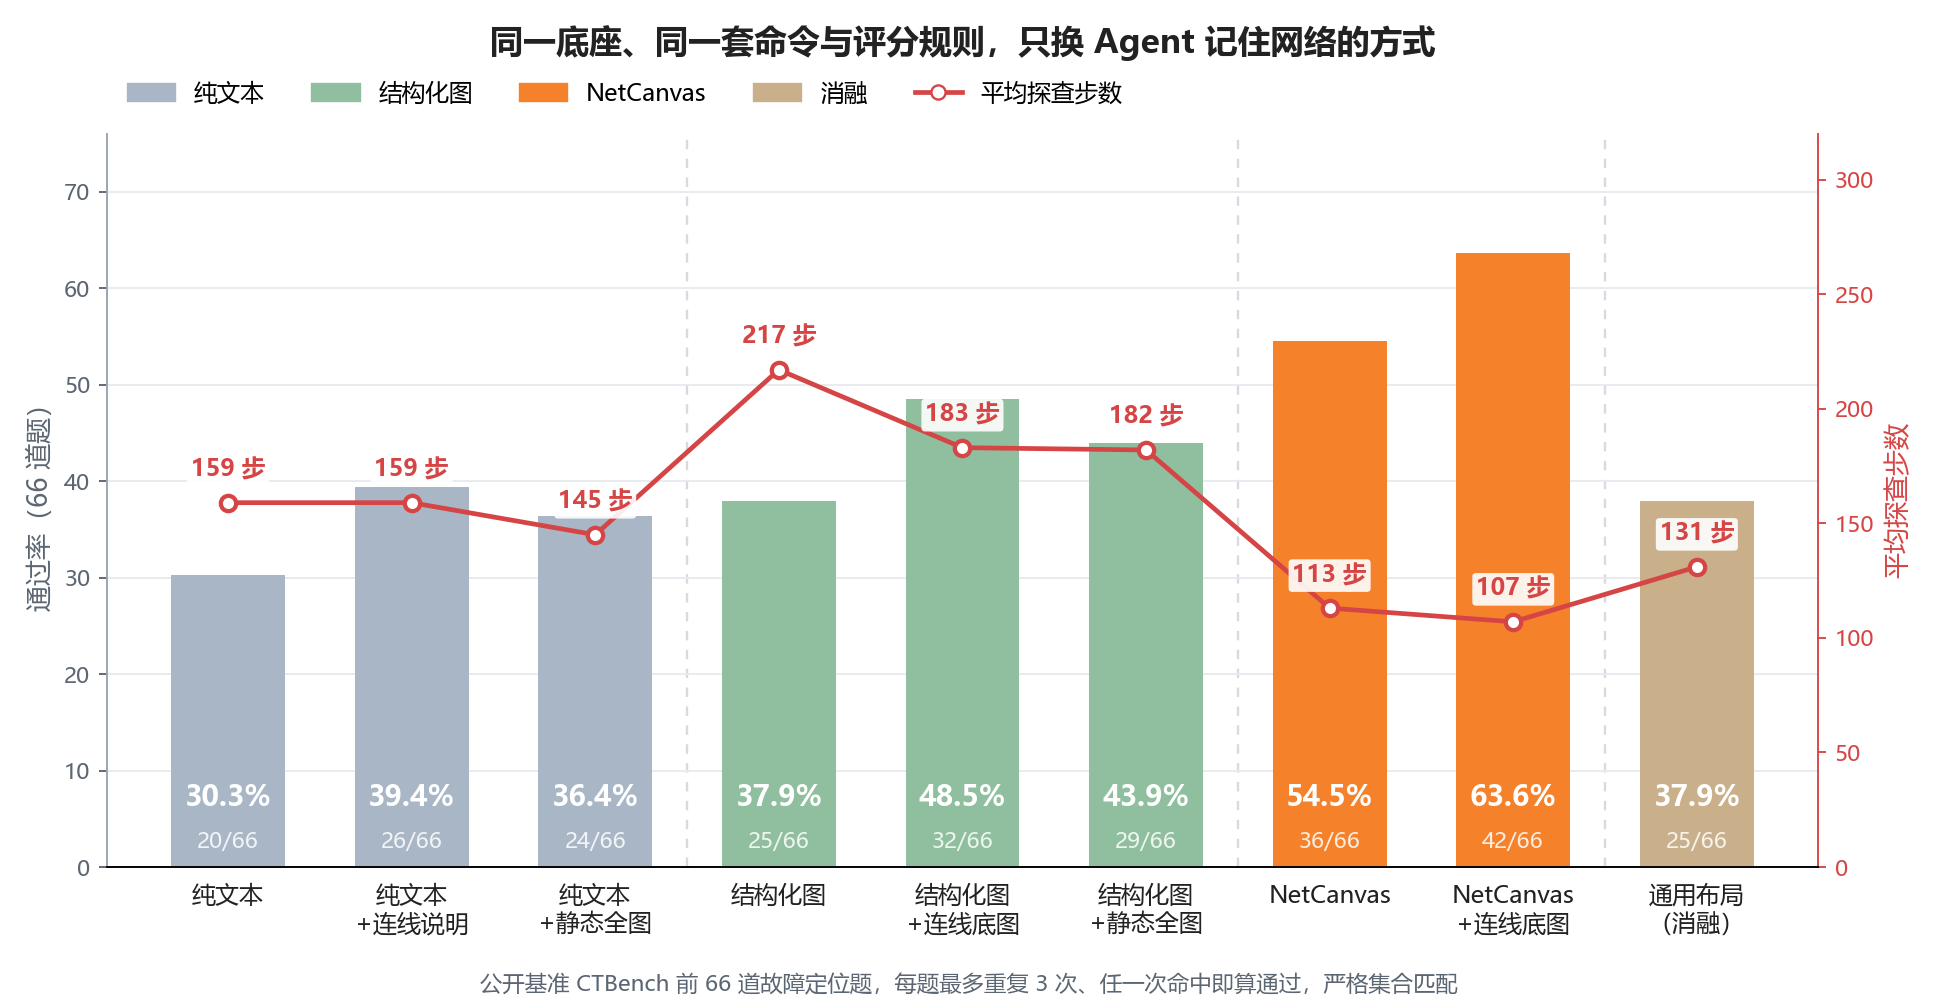
发现一:只换工作记忆的组织方式,通过率从 30.3% 提到 54.5%
九条对照臂的完整数字如下(步数为平均每次运行的工具调用次数,成功与失败都计入):
| 工作记忆形态 | 答对题数 | 通过率 | 平均步数 |
|---|---|---|---|
| 纯文本 | 20/66 | 30.3% | 159 |
| 纯文本 + 开局静态图 | 24/66 | 36.4% | 145 |
| 纯文本 + 预置连线数据 | 26/66 | 39.4% | 159 |
| JSON 结构化图 | 25/66 | 37.9% | 217 |
| JSON 结构化图 + 开局静态图 | 29/66 | 43.9% | 182 |
| JSON 结构化图 + 预置连线数据 | 32/66 | 48.5% | 183 |
| NetCanvas | 36/66 | 54.5% | 113 |
| NetCanvas,换通用力导向布局 | 25/66 | 37.9% | 131 |
| NetCanvas + 预置连线数据 | 42/66 | 63.6% | 107 |
净对照是纯文本与 NetCanvas 那两行:36 道对 20 道,逐题配对 16 胜、0 负、50 平。表里最高的 63.6% 是 NetCanvas 再加预置连线数据,那是「工作记忆 + 预置数据」的上限。
发现二:赢的不是「有图」,而是随探查更新的交互视图——JSON、静态图、通用布局都追不上
JSON 结构化图 37.9%,平均 217 步,单次 Token 约为 NetCanvas 的两倍。后台同样入图,前台只给符号,空间关系进不了模型能直接用的那一层。
开局静态图:纯文本 24 道、结构化图 29 道,都低于会重绘、会高亮的 36 道。对纯文本 Agent 来说,预置连线数据(26 道)甚至比给一张静态图更好用,但仍然明显弱于随探查更新的交互视图。
只换布局:36 道掉到 25 道,配对 11 胜 0 负,退回和 JSON 同一档。入图和交互协议都没变,摊开的节点对视觉推理是干扰。这验证了 02 节的第三个设计决定:领域布局是信息。
预置连线数据对各形态都有用,但抹不平差距。 三类各多答对 6–7 道(20→26、25→32、36→42),排序不变;不预置的 NetCanvas(54.5%)仍高于预置了的结构化图(48.5%)。它给的只是谁连着谁,路由、策略、端口状态还是要自己去查。
发现三:增益集中在最依赖空间记忆的场景——平行路径题从 10% 拉到 90%
把 66 道题按故障场景拆开:
| 故障场景 | 题数 | 纯文本 | JSON 结构化图 | NetCanvas | NetCanvas + 预置连线 |
|---|---|---|---|---|---|
| 防火墙策略与出接口 | 11 | 90.9% | 90.9% | 100% | 100% |
| 双防火墙 HRP / ECMP 平行路径 | 10 | 10.0% | 20.0% | 90.0% | 90.0% |
| 总部核心 STP / 二层拓扑 | 8 | 50.0% | 75.0% | 87.5% | 100% |
| 跨园区访客接入 | 6 | 0 | 16.7% | 16.7% | 83.3% |
| 跨城 L3VPN 路由异常 | 15 | 0 | 0 | 6.7% | 13.3% |
| AP 上联 / 核心侧 STP | 6 | 0 | 0 | 0 | 0 |
差距最大的一行就是 01 节那道双防火墙题所在的簇。短路径策略题各方案本来就高,这层机制几乎没有额外空间。跨城 VPN 上各方案都弱,NetCanvas 也只有 6.7%,瓶颈已不在工作记忆形态。
发现四:更准的同时也更省——看图省掉的是纯文本的反复试错
画图会把视觉上下文送进窗口,单次任务总 Token 并不比纯文本更低,但明显低于 JSON 方案;与此同时,NetCanvas 的平均工具调用步数从纯文本的 159 步降到 113 步。
把增益逐题回看之后更具体:多答对的题主要赢在探查覆盖率。有了空间化的局部视图和路径高亮,原来漏掉的那台设备被查到了——CLI 翻查变成了沿着看得见的结构做机制验证。
发现五:这层机制的边界——剩下的错题缺的是抽取和推理,不是画图
这 30 道逐题回看了轨迹、入图记录和最终答案,并按三个环节及其组合归因:证据层(关键命令发了,抽取模型没把回显结构化进图)、探查层(关键探查没发生,或拿到线索没有跟下去)、推理层(证据都在上下文里了,仍收不成最小根因)。实际形成下面四种组合:
| 失败卡在哪一层 | 题数 | 占 30 道失败题 |
|---|---|---|
| 证据层 + 推理层 | 14 | 46.7% |
| 探查层 + 推理层 | 9 | 30.0% |
| 探查层 + 证据层 | 5 | 16.7% |
| 纯推理层 | 2 | 6.7% |
这层机制能接走的,是「组织和记录不可靠」那一层。抽取模型面对 VRF/RT、前缀列表时的结构化能力,和模型拿到证据后的多跳因果收敛,要分别靠强化抽取模型和领域后训练去补。这也对上发现三:平行路径抬得上去,因为缺的是覆盖;跨城 VPN 抬不上去,因为缺的是抽取和推理。
还有一层边界:这 66 道题背后是同一张网——企业园区加跨城星型组网。在这类多站点网络里,交互视觉工作记忆能卸掉路径追踪和局部拓扑理解的负担;换成数据中心的 spine-leaf、更大规模的骨干网或更高密度的多租户云网,领域布局这个先验还成不成立,需要重新验证。
04 / 终极启示:学会「认知卸载」,构建专业 Agent 的新范式
NetCanvas 的实践,揭示了专业 Agent 走向现网落地的核心命题:模型本身的理解能力固然重要,但外围系统(Harness)如何为它呈现这个真实世界,才真正决定了它最终的战斗力。
对于 IP 网络这种由拓扑、路径、协议动态交织的真实复杂系统,把海量日志生硬地压进大模型的 Token 里,注定会导致认知超载。Agent 除了需要强大的语言理解能力,更需要一套能持续演化的「延展工作记忆」。真正的专业能力,不仅仅依赖于模型内部庞大的“知识储备”与强大的“推理决策”,更在于懂得借助外围系统来进行“认知卸载”,建立起真正的网络空间全局观。
这也是华为 GTS AI 始终坚守的技术演进路径:从真实的运维现场出发,将资深工程师长期沉淀的“空间认知与工作方式”工程化,转化为 Agent 可感知、可交互的系统能力。
未来的网络智能运维,Agent 将彻底告别在海量碎片日志中“大脑超载、盲人摸象”的窘境。有了「可交互视觉拓扑」的驱动,AI 终于可以像顶尖专家一样,看着网络、沿着路径,精准排障。
项目地址
- NetCanvas:NetCanvas.pdf
- CTBench:https://huggingface.co/datasets/netop/CTBench
— 完 —
引用本文
@misc{netcanvas2026,
  title  = {{NetCanvas}: Interactive Visual Working Memory for LLM-Based IP Network Fault Localization},
  author = {Cai, Manjing and Wu, Chenwei and You, Qiheng and Sun, Weijian and Chen, Xin},
  year   = {2026},
  note   = {Preprint},
  url    = {https://caimanjing.github.io/netcanvas/}
}项目主页:https://caimanjing.github.io/netcanvas/。论文 PDF 见页首「论文 PDF」按钮。